Sprachtechnologie

Was ist KI-Stimmenklonen und wie funktioniert es?

Was ist KI-Stimmenklonen? Dabei handelt es sich um eine Technologie, die die erkennbaren Merkmale der Sprache einer Person aus aufgezeichnetem Audiomaterial erlernt und anschließend mithilfe eines Modells neue gesprochene Wörter mit einer ähnlichen Stimme erzeugt. Das Ergebnis ist generierte Sprache und keine Aufnahme, in der die Person jeden einzelnen Satz spricht.

Mit der Idee beginnen

KI-Stimmenklonen erstellt anhand von Sprachproben ein digitales Stimmenmodell, sodass Text mit ähnlichen stimmlichen Eigenschaften wiedergegeben werden kann.

Rollen in der Praxis

Wer nutzt es?

Dieselbe zugrunde liegende Technologie kann Barrierefreiheit, Produktion, Lokalisierung und private Experimente unterstützen, wenn die Zustimmung der sprechenden Person und der beabsichtigte Verwendungszweck eindeutig sind.

Content-Ersteller

Ein Creator benötigt eine konsistente Erzählstimme für eine Serie, kann jedoch nicht jede Überarbeitung in derselben Sitzung aufnehmen.

Ein genehmigtes Stimmenmodell kann überarbeitete Zeilen mit einer konsistenteren Wiedergabe erzeugen, während der Creator weiterhin für die Prüfung des fertigen Audiomaterials verantwortlich ist.

Voice AI Text-to-Speech
Teams für Barrierefreiheit

Ein Produktteam möchte schriftliche Inhalte in einer Stimme ausgeben lassen, die für einen bestimmten Service oder Präsentator ausgewählt wurde.

Generierte Erzählungen können die Erstellung von Aktualisierungen erleichtern, sofern Zuhörer nicht darüber getäuscht werden, ob das Audio live oder synthetisch ist.

Sind Sprachassistenten KI?

Medien- und Lokalisierungsteams

Ein Verlag passt genehmigte Skripte für mehrere Ausgaben an und bewahrt dabei den wiedererkennbaren Stil des Präsentators.

Ein Sprachmodell kann den Aufwand für wiederholte Aufnahmen verringern, doch Aussprache, kultureller Kontext und Einwilligung müssen weiterhin von Menschen geprüft werden.

kostenloses Voice AI online

Forschende und Entwickler

Ein Team testet Sprachschnittstellen, Dialogsysteme oder Audio-Prototypen mit einer kontrollierten Referenzstimme.

Voice Cloning kann Experimente besser reproduzierbar machen, ohne die Identität einer echten Person über den vereinbarten Umfang hinaus zu verwenden.

Voice AI Google Studio

Im Modell

So funktioniert es

Ein typischer Ablauf wandelt eine erlaubte Aufnahme in eine Sprachrepräsentation um und kombiniert diese anschließend mit neuem Text und Sprachsteuerungen.

  1. 1

    Eine Sprachprobe bereitstellen

    Das System analysiert eine oder mehrere Aufnahmen auf Merkmale wie Aussprache, Sprechtempo, Tonhöhenverlauf, Klangfarbe und Pausen. Eine klarere und konsistentere Sprache liefert dem Modell im Allgemeinen eine eindeutigere Referenz.

  2. 2

    Eine Sprachrepräsentation erstellen

    Ein Machine-Learning-Modell trennt sprachliche Inhalte von Merkmalen, die mit der sprechenden Person verbunden sind. Es speichert keine magische Kopie jedes möglichen Satzes, sondern schätzt, wie die Stimme bei der Erzeugung neuer Inhalte klingen könnte.

  3. 3

    Audio erzeugen und prüfen

    Der Text wird durch das trainierte Sprachmodell geleitet, um Sprache zu synthetisieren. Menschen sollten Aussprache, Betonung, unnatürliche Formulierungen und die Frage prüfen, ob die Ausgabe Zuhörende darüber täuschen könnte, wer tatsächlich gesprochen hat.

Wichtige Grenzen

Was es kann und was nicht

Ein Sprachmodell kann Sprachmuster reproduzieren, aber es bestätigt weder Identität noch Absicht, Urheberschaft oder Einwilligung.

  • Es kann keine perfekte Ähnlichkeit garantieren

    Erzeugtes Audio kann im Klang ähnlich wirken und dennoch subtile Unterschiede bei Timing, Emotion, Akzent oder der natürlichen Reaktion der sprechenden Person auf den Kontext aufweisen.

    Alternative LösungVerwenden Sie Prüfaufnahmen und passen Sie Skripte, Aussprache, Sprechtempo oder Steuerungen für die Darbietung vor der Veröffentlichung an.

  • Es kann keine Einwilligung schaffen

    Das Vorhandensein einer Probe bedeutet nicht, dass die sprechende Person jedem zukünftigen Skript, Publikum, jeder Sprache oder kommerziellen Nutzung zugestimmt hat.

    Alternative LösungDokumentieren Sie die Einwilligung, legen Sie die zulässige Nutzung fest und schaffen Sie eine Möglichkeit, das Projekt zu stoppen oder zu ändern.

  • Es kann nicht überprüfen, wer spricht

    Eine überzeugende synthetische Stimme ist kein verlässlicher Beweis dafür, dass die genannte Person eine Aussage gemacht oder einer Handlung zugestimmt hat.

    AlternativeNutzen Sie für sensible Entscheidungen unabhängige Identitätsprüfungen, unterzeichnete Genehmigungen und vertrauenswürdige Kommunikationskanäle.

  • Es kann redaktionelles Urteilsvermögen nicht ersetzen

    Das Modell kann Namen falsch aussprechen, Bedeutungsnuancen einebnen oder einen Vortrag erzeugen, der technisch klar, aber für die Situation unangemessen ist.

    AlternativeBehalten Sie bei faktischen, emotionalen, rechtlichen und öffentlich zugänglichen Inhalten einen menschlichen Prüfschritt bei.

Klare Abgrenzung

Stimmklonen im Vergleich zu herkömmlicher Text-zu-Sprache-Technologie

Beide Systeme können geschriebenen Text in Audio umwandeln, verfolgen bei der erzeugten Stimme aber unterschiedliche Ziele.

1

Hauptziel

KI-Stimmklonen

Ausgewählte Merkmale einer Referenzstimme reproduzieren, für deren Nutzung eine Genehmigung vorliegt.

Herkömmliche Text-zu-Sprache-Technologie

Verständliche Sprache mit einer allgemeinen oder vorgefertigten synthetischen Stimme erzeugen.

2

Erforderliche Eingabe

KI-Stimmklonen

Umfasst in der Regel Sprachaufnahmen der Referenzstimme.

Herkömmliche Text-zu-Sprache-Technologie

Erfordert in der Regel Text und die Auswahl einer verfügbaren Stimme.

3

Identitätsmerkmal

Voice AI-Stimmklonen

Entwickelt, um dem Stimmprofil einer bestimmten sprechenden Person zu ähneln.

Standard-Text-to-Speech

Entwickelt für eine Stimmoption, nicht unbedingt für eine namentlich genannte Person.

4

Hauptsteuerung

Voice AI-Stimmklonen

Ähnlichkeit, Aussprache, Sprechtempo und Vortrag der Referenzstimme.

Standard-Text-to-Speech

Steuerung von Sprache, Stimmstil, Geschwindigkeit, Tonhöhe und Aussprache.

5

Hauptrisiko

Voice AI-Stimmklonen

Imitation, unbefugte Nutzung oder Verwirrung darüber, wer gesprochen hat.

Standard-Text-to-Speech

Fehlaussprache, unnatürlicher Vortrag oder eine ungeeignete Stimmenauswahl.

6

Wichtigste Prüffrage

Voice AI-Stimmklonen

Liegt für diese Nutzung eine Genehmigung vor, und könnten Zuhörende die Quelle missverstehen?

Standard-Text-to-Speech

Ist die ausgewählte Stimme für den Inhalt klar, passend und präzise?

7

Typische Ausgabe

Voice AI-Stimmklonen

Neue Sätze, die mit Merkmalen wiedergegeben werden, die mit der Referenzstimme verbunden sind.

Standard-Text-to-Speech

Neue Sätze, die in einem allgemeinen synthetischen Stimmstil wiedergegeben werden.

Höre den Unterschied

Von der Quellenaufnahme zur generierten Sprache

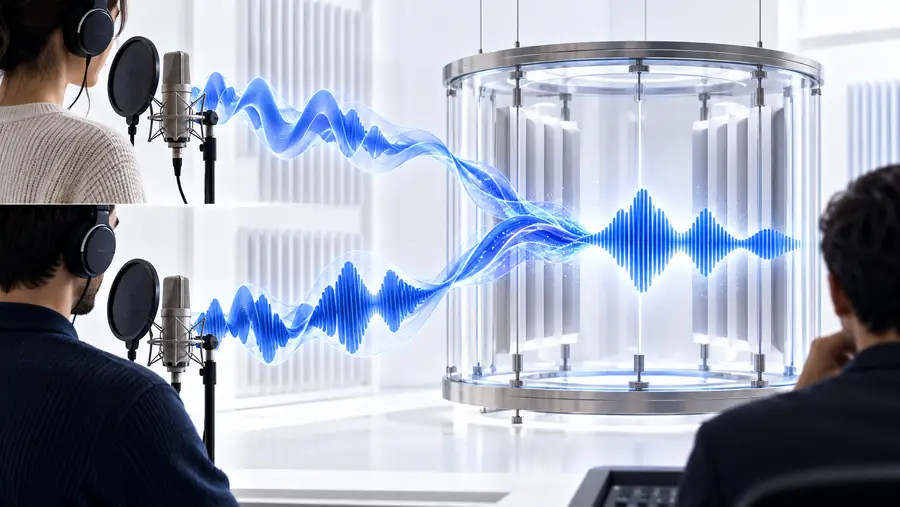
Die Umwandlung ist keine einfache Audiokopie. Das Modell verwendet eine Referenzstimme, um neue Wörter zu synthetisieren, die in der Originalaufnahme nicht vorkamen.

  • Referenzbeispiel
  • Synthetisierte Ausgabe

Die Ausgabe sollte auf Genauigkeit, Einwilligung und Verständlichkeit für die Zuhörenden geprüft werden.

Referenz-Sprachaufnahme für ein Stimmenmodell
Aus einer neuen Texteingabe erzeugte Sprachwellenform

Ein hilfreiches Denkmodell

Drei Teile des Prozesses

Diese drei Konzepte helfen dabei, bei der Bewertung eines Klon-Workflows zwischen der Aufnahme, dem Modell und dem finalen Audio zu unterscheiden.

1 Die Referenzsprache liefert die stimmlichen Belege.
01 Beispiel
2 Eine erlernte Repräsentation schätzt, wie die Stimme sprechen könnte.
02 Modell
3 Neuer Text wird zu Audio, das eine menschliche Prüfung erfordert.
03 Ausgabe

Verantwortungsvoll verwenden

Eine Sprachidee in einen geprüften Audio-Workflow verwandeln

Voice Ai kann dir helfen, synthetische Sprache zu erkunden. Der beste Workflow beginnt jedoch mit einem klaren Zweck, dokumentierter Einwilligung und einem Prüfschritt, bevor jemand das Ergebnis hört. Verwende das Tool für eine genehmigte Stimme und behalte die vorgesehene Zielgruppe im Blick.

Sprachtools ausprobieren
  • Mit dokumentierbarer Einwilligung beginnen
  • Namen, Tonfall und Aussprache prüfen
  • Zuhörenden mitteilen, wenn synthetisches Audio relevant ist

Fragen beantwortet

Häufig gestellte Fragen

Es ist eine Möglichkeit, neue Sprache zu erzeugen, die der Stimme einer bestimmten Person ähnelt, indem Aufnahmen analysiert und aus neuem Text Audiodateien generiert werden. Die Ausgabe ist synthetisch, selbst wenn sie der Referenzstimme ähnlich klingt.

Ein Modell untersucht Sprachmuster wie Tonfall, Timing, Aussprache, Tonhöhenverlauf und Stimmklang. Anschließend verwendet es diese erlernten Muster, um einzuschätzen, wie die Referenzstimme Wörter sprechen könnte, die in der ursprünglichen Aufnahme nicht vorkamen.

Es kann viele neue Sätze erzeugen, aber die Qualität hängt von der Aufnahme, der Sprache, der Aussprache, dem Skript und den verfügbaren Einstellungen ab. Namen können weiterhin falsch ausgesprochen werden, emotionale Nuancen verloren gehen oder die Stimme unnatürlich klingen, daher ist eine Überprüfung erforderlich.

Nein. Eine überzeugende Stimme ist kein zuverlässiger Beleg für Identität, Zustimmung oder Urheberschaft. Sensible Anfragen sollten über einen unabhängigen Kanal bestätigt werden, statt ihnen zu vertrauen, nur weil ein Audioclip vertraut klingt.

Die Erlaubnis ist ein wesentlicher Ausgangspunkt, aber die genauen Anforderungen hängen von der Nutzung, dem Standort, dem Vertrag und dem geltenden Recht ab. Legen Sie fest, wer das Modell wofür und wie lange verwenden darf und wie die Erlaubnis widerrufen oder geändert werden kann.

Erstellung starten
Erstellung starten