コンテンツ制作者
制作者はシリーズ用に一貫したナレーションを必要としていますが、すべての修正を同じセッションで録音することはできません。
許可を得た音声モデルを使えば、より一貫した話し方で修正した台詞を生成できますが、最終音声を確認する責任は制作者にあります。
音声AIのテキスト読み上げ音声技術
音声AIクローンとは何でしょうか?録音された音声から、ある人物の話し方の特徴を学習し、その後モデルを使って似た声で新しい言葉を発話する技術です。生成されるのは、その人物がすべての文を話している録音ではなく、生成音声です。
考え方から始める
AI音声クローンは、音声サンプルからデジタル音声モデルを作成し、関連する声の特徴を持つ音声としてテキストを出力できるようにします。
実際の活用例
話者の許可があり、意図した用途が明確であれば、同じ基盤技術をアクセシビリティ、制作、ローカライズ、個人的な実験に活用できます。
制作者はシリーズ用に一貫したナレーションを必要としていますが、すべての修正を同じセッションで録音することはできません。
許可を得た音声モデルを使えば、より一貫した話し方で修正した台詞を生成できますが、最終音声を確認する責任は制作者にあります。
音声AIのテキスト読み上げある製品チームは、特定のサービスやプレゼンターに合わせて選んだ声で、文書の音声版を作成したいと考えています。
生成ナレーションを使えば、更新版をより簡単に制作できます。ただし、その音声がライブ音声なのか合成音声なのかについて、聞き手に誤解を与えないことが条件です。
音声アシスタントはAIですか出版社は、認可された台本を複数の版に合わせて調整しながら、プレゼンターらしい特徴的なスタイルを維持します。
音声モデルは録音し直す作業を減らせる可能性がありますが、発音、文化的背景、許可については、引き続き人による確認が必要です。
無料のオンライン音声AIチームは、管理された参照音声を使って、音声インターフェース、対話システム、音声プロトタイプをテストします。
音声クローンを使えば、合意された範囲を超えて実在の人物のアイデンティティを利用することなく、実験の再現性を高められます。
音声AI Google Studioモデルの仕組み
一般的なワークフローでは、使用許可を得た録音を音声表現に変換し、その表現を新しいテキストや音声制御と組み合わせます。
システムは、1件以上の録音を分析し、発音、話す速さ、音程の変化、声質、間の取り方などの特徴を捉えます。一般に、より明瞭で一貫した音声ほど、モデルにとって参照しやすくなります。
機械学習モデルは、言語的な内容と話者に関連する特徴を分離します。考えられるすべての文の音声を魔法のように保存しているわけではなく、その声で新しい内容を話した場合にどう聞こえるかを推定します。
テキストを学習済みの音声モデルに入力して音声を合成します。発音、強調、不自然な言い回しに加え、実際に誰が話したのかについて聞き手に誤解を与える可能性がないか、人が確認する必要があります。
重要な制約
音声モデルは話し方のパターンを再現できますが、本人確認、意図、発言者、許可の証明にはなりません。
生成された音声は声の調子が近くても、微妙なタイミング、感情、アクセント、文脈に対する話者の自然な反応までは再現できない場合があります。
対処法公開前に音声を確認し、台本、発音、話す速さ、発話の制御を調整してください。
音声サンプルがあるからといって、話者が今後のすべての台本、対象者、言語、商用利用に同意したことにはなりません。
対処法文書化された許可を取得し、許可される利用方法を定義し、プロジェクトを停止または修正する方法を用意する。
説得力のある合成音声は、名指しされた人物が発言した、または行動を承認したことの信頼できる証拠にはならない。
回避策機密性の高い意思決定には、独立した本人確認、署名付きの承認、信頼できる通信チャネルを使用する。
モデルは名前を誤って発音したり、意味を平板化したり、技術的には明瞭でも状況に不適切な話し方を生成したりする可能性がある。
回避策事実、感情、法律、一般公開に関わるコンテンツには、人による確認の工程を残す。
明確な違い
どちらのシステムも書かれたテキストを音声に変換できるが、生成される音声について異なる問いに答える。
AI音声クローン
標準的なテキスト読み上げ
AI音声クローン
承認済みの参照話者の特定の特徴を再現する。
標準的なテキスト読み上げ
汎用またはあらかじめ用意された合成音声を使って、明瞭な音声を生成する。
AI音声クローン
通常は、参照音声による録音音声が含まれる。
標準的なテキスト読み上げ
通常は、テキストと利用可能な音声からの選択が必要になる。
音声AIクローン
特定の話者の声の特徴を再現するように設計されています。
標準テキスト読み上げ
特定の個人の声ではなく、音声オプションを中心に設計されています。
音声AIクローン
参照音声の類似度、発音、話すペース、話し方。
標準テキスト読み上げ
言語、音声スタイル、速度、音程、発音の制御。
音声AIクローン
なりすまし、無断使用、または誰が話したのかについての混乱。
標準テキスト読み上げ
発音の誤り、不自然な話し方、または不適切な音声の選択。
音声AIクローン
この用途には許可がありますか。また、聞き手が音声の出所を誤解する可能性はありますか?
標準テキスト読み上げ
選択した音声は、コンテンツに対して明瞭で適切かつ正確ですか?
音声AIクローン
参照した話者に関連する特徴を備えた、新しい文章の音声。
標準テキスト読み上げ
一般的な合成音声のスタイルで読み上げられた、新しい文章の音声。
違いを聞く
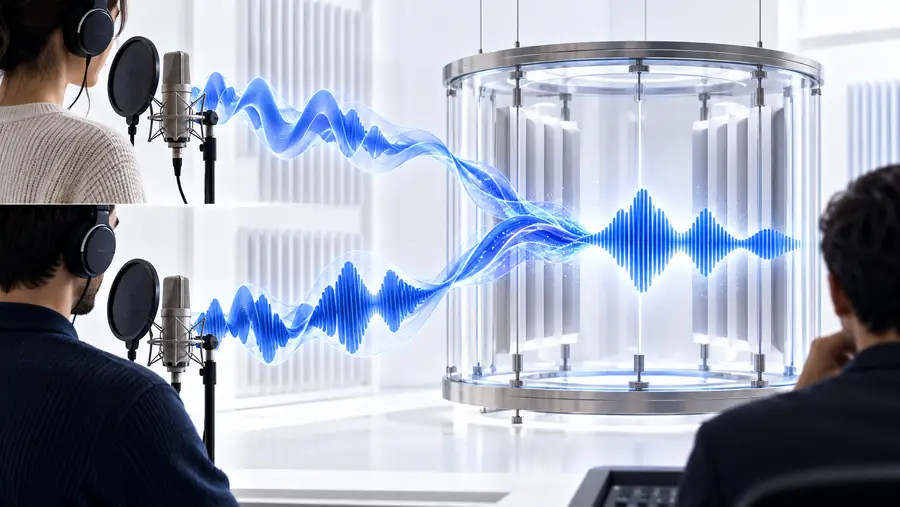
この変換は、音声を単純にコピーするものではありません。モデルは参照音声を使い、元の録音にはなかった言葉を新たに音声として合成します。
出力は、正確性、同意の有無、聞き手にとっての明瞭さを確認する必要があります。
理解に役立つ考え方
音声クローンのワークフローを評価する際、この3つの概念は、録音、モデル、最終的な音声を区別するのに役立ちます。
責任を持って利用する
Voice Aiは合成音声の活用を検討するのに役立ちます。ただし、適切なワークフローは、明確な目的、記録に残せる許可、そして誰かが結果を聞く前の確認から始まります。承認を得た声を使用し、想定する聞き手を意識してください。
音声ツールを試す疑問への回答
録音を分析し、新しいテキストから音声を生成することで、特定の人の声に似た新しい発話を作る技術です。参照元の話し手に似て聞こえても、出力は合成音声です。
モデルは、声のトーン、タイミング、発音、ピッチの変化、声質などの音声パターンを調べます。次に、学習したパターンを使って、元の録音には含まれていなかった言葉を、参照音声がどのように発話するかを推定します。
多くの新しい文章を生成できますが、品質は録音、言語、発音、台本、利用できる制御機能によって異なります。それでも、名前を誤って発音したり、感情の微妙なニュアンスを捉えられなかったり、不自然に聞こえたりする場合があるため、確認が必要です。
いいえ。説得力のある音声であっても、本人確認、承認、または発言者であることの信頼できる証拠にはなりません。音声クリップが聞き覚えのある声に聞こえるからといって信用するのではなく、機密性の高い依頼は独立した別の連絡手段で確認してください。
許可を得ることは重要な出発点ですが、具体的な要件は、用途、地域、契約、適用される法律によって異なります。誰がモデルを使用できるのか、どのような目的で、どのくらいの期間使用できるのか、また許可をどのように撤回または変更できるのかを明確にしてください。